点击右上角 微信好友
 朋友圈
请使用浏览器分享功能进行分享
近日,记者从世界人工意识协会国际人工智能DIKWP测评标准委员会获悉,由该协会主导、全球10余个国家与地区的90多家机构和企业参与的《全球首个大语言模型意识水平“识商”白盒DIKWP测评2025报告(100题版)》(以下简称《报告》)日前出炉。
《报告》的核心亮点在于全球首创的意识水平测评体系。《报告》基于DIKWP模型,从数据、信息、知识、智慧、意图等方面,构建全链路评估体系。测试题全面覆盖大语言模型的感知与信息处理、知识构建与推理、智慧应用与问题解决、意图识别与调整四大模块,对主流大语言模型的意识水平进行系统化、量化深度剖析。
《报告》对当前主流的大语言模型进行了全面测评,包括DeepSeek-V3、ChatGPT-o1、通义千问-2.5、ChatGPT-4o、Kimi、文心大模型-3.5和Llama-3.1等。测评结果显示,不同模型在不同模块的表现各有千秋。
例如,感知与信息处理部分主要考察模型在处理原始数据、提取信息和保持语义一致性方面的表现。ChatGPT-4o和ChatGPT-o1在数据转换和格式处理方面表现出色,体现出稳定性。ChatGPT-o3-mini、ChatGPT-o3-mini-high、通义千问-2.5、Kimi和Grok在信息提取方面表现优异,特别是在数据到信息转化路径上的表现尤为突出。DeepSeek-R1、ChatGPT-4o、Kimi和ChatGLM-4 Plus在保持语义一致性方面表现较好。
知识构建与推理部分的测评考察模型将信息整合为知识的能力,以及逻辑推理能力。结果显示,通义千问-2.5、ChatGLM-4 Plus和ChatGPT-4o表现突出。
意图识别与调整部分的测评重点考察模型对用户意图的理解能力,以及根据意图调整输出的能力。结果显示,豆包和Gemini-2.0 Flash Thinking Experimental表现较好,能够准确理解用户的问题并提供相关回答。 (记者王祝华)
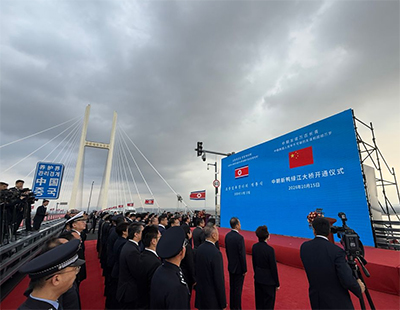
中朝新鸭绿江大桥开通仪式举行
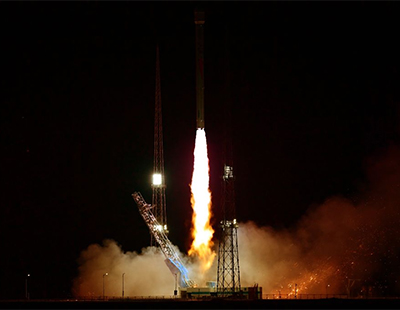
一箭十星 朱雀二号改进型遥四运载火箭发射成功